AIモデルの変遷は、2024年後半から別の段階へ入りました。すぐに返事をするだけでなく、難問を考え、コードを直し、複数の操作を進める方向です。後編では「考えるAI」「公開モデル」「作業するAI」が競争をどう変えたかを、2026年9月まで追います。
2024年:考える時間が性能を左右する
2025年:DeepSeekが価格と公開方式の競争を強める
2026年:仕事の完了率・費用・安全な操作が焦点になる
情報基準日:2026年9月30日(日本時間)。リリース日は原則として開発元の発表日。性能値は記載資料の評価結果であり、当サイトの実測ではありません。前編ではChatGPT普及と2023〜2024年の競争を解説しています。
2024年9月|o1が「即答以外」の価値を示した
OpenAIは2024年9月12日、o1-previewとo1-miniを公開しました。難しい問題に対し、回答前に時間を使って推論する方向を明確にしたモデルです。複雑な数学やコードの問題では、早く一文を出すことより、途中で誤りを見直すことが役立ちます。[OpenAI発表]
利用者にとっての強みは、条件が絡み合う課題を段階的に処理しやすくなること。弱みは待ち時間と費用です。短い挨拶文の言い換えまで、毎回長く考えさせる必要はありません。また、長く考えた回答でも事実誤認は残ります。「考えた跡が長い」ことを正しさの証明にしない方がよいでしょう。
この変化は、AIの進歩をモデルの大きさだけで説明しにくくしました。学習にどれだけ計算を使ったかに加え、利用時にどれだけ考えさせるかも効くためです。同じモデルでも設定を変えると速度や点数が変わる。後の性能比較で「推論量」を確認する必要が出てくる理由です。
2024年末〜2025年1月|DeepSeekが競争の前提を揺らす
DeepSeekは2024年12月にV3、2025年1月20日にR1を公開しました。R1は推論を重視し、モデルの重みや技術資料、小型の蒸留モデルを公開しました。蒸留とは、大きなモデルの出力などを使い、小さなモデルへ能力を移す学習の方法です。技術の名称だけで不正な行為を意味するわけではありません。[R1公開発表]/[公式リポジトリ]
R1の公開時API料金は、100万トークン当たり入力0.55ドル(キャッシュなし)、出力2.19ドルでした。これは当時のサービス利用単価です。モデルの研究開発費でも、現在の料金でもありません。「安い」の対象を混ぜると、ニュースを読み違えます。
市場の反応は大きく、Reutersによると2025年1月27日のNVIDIA株は17%下落し、時価総額を約5,930億ドル失いました。低費用で高性能なAIを作れるのではないかという懸念が広がった局面です。ただし、1日の株価変動は将来の半導体需要が確定した証拠ではありません。[Reuters]
開発者にとっての意味は、選択肢の拡大です。APIを利用する、自社の環境で動かす、小型モデルを組み込む、といった設計を検討しやすくなる。一方、自社運用ではGPU、運用担当、更新や監視が必要です。無料でダウンロードできることと、安く安全に運用できることは同じではありません。
グラフで比較|知識の多さと、難問を解く力は別
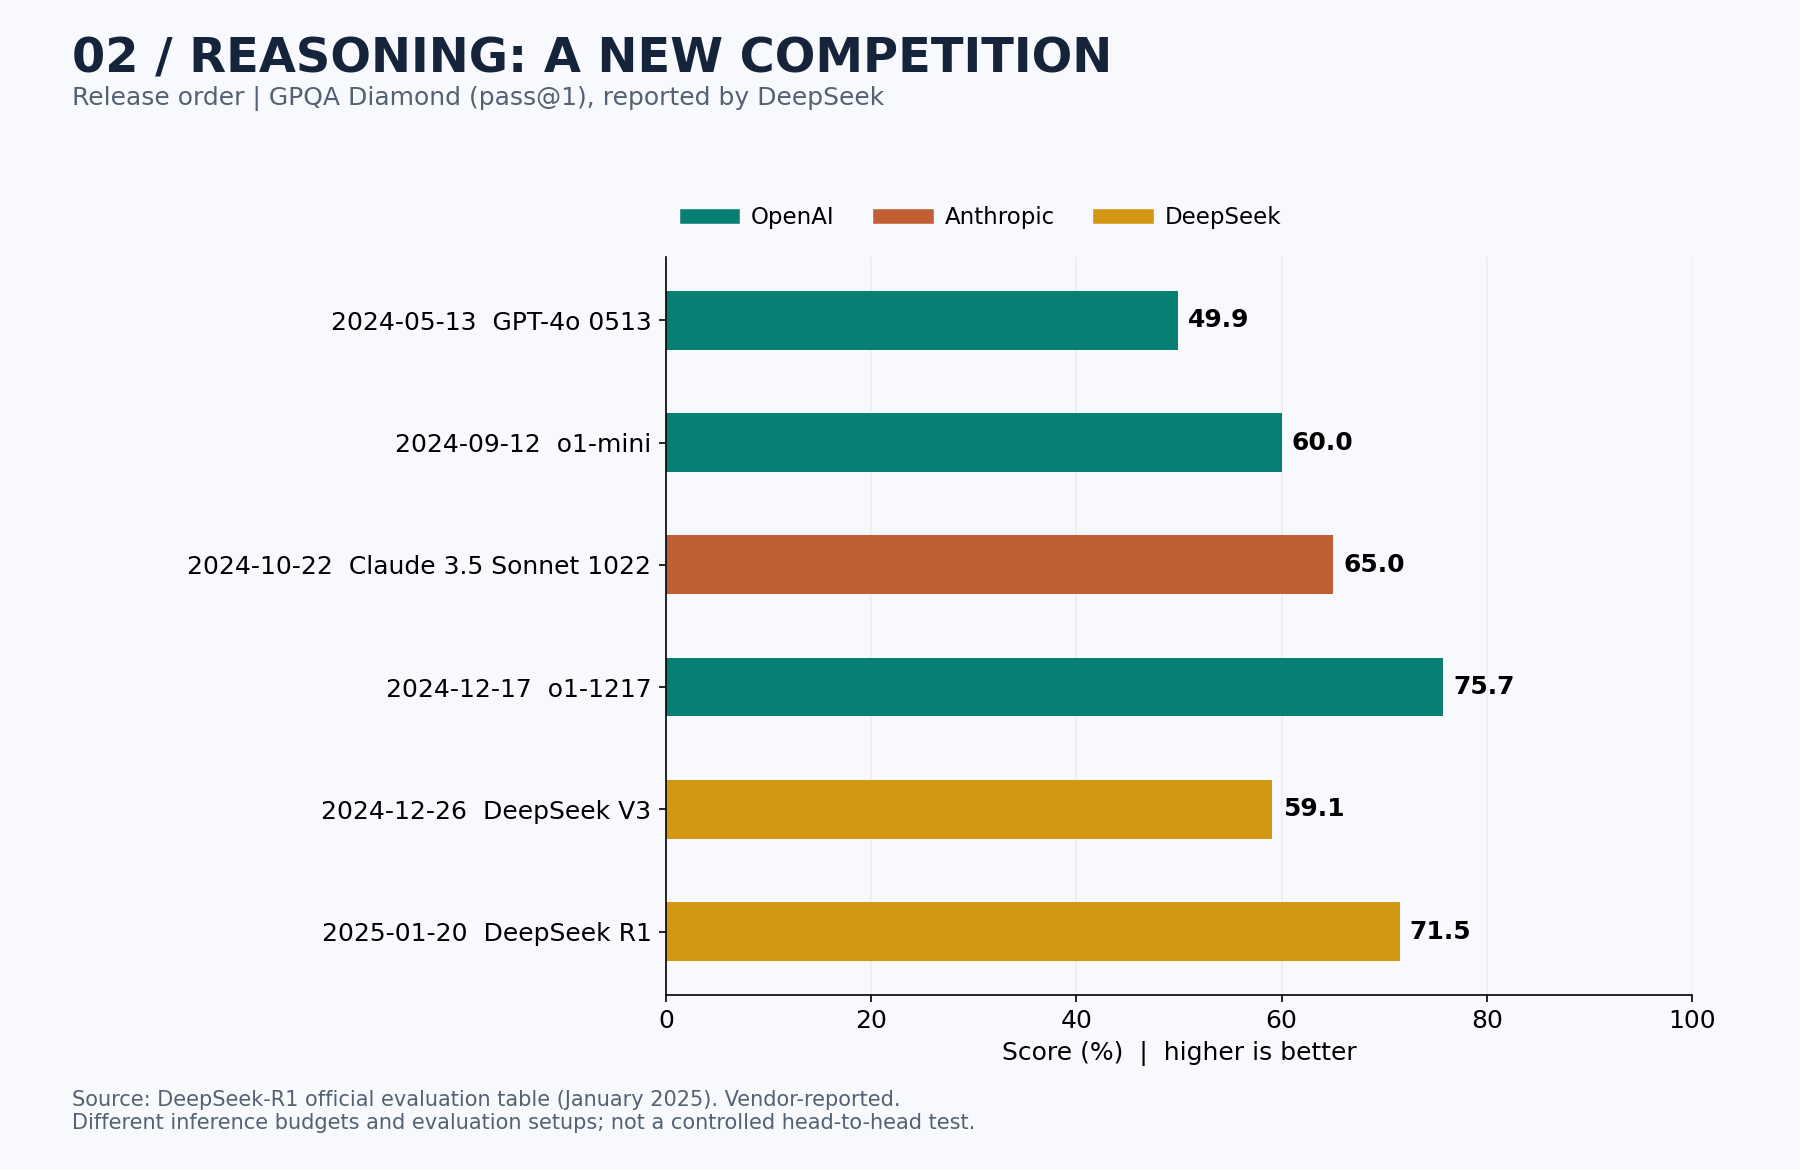
GPQA Diamondは、科学分野の難しい選択式問題を使う評価です。以下はDeepSeek-R1の公式比較表から、2024年5月〜2025年1月に公開された6モデルをリリース順に表示したもの。前編のMMLUとは別の試験なので、点数をつないで一本の「AI知能曲線」にすることはできません。
| 公開日/モデル | GPQA Diamond |
|---|---|
| 2024/5/13 GPT-4o 0513 | 49.9% |
| 2024/9/12 o1-mini | 60.0% |
| 2024/10/22 Claude 3.5 Sonnet 1022 | 65.0% |
| 2024/12/17 o1-1217 | 75.7% |
| 2024/12/26 DeepSeek V3 | 59.1% |
| 2025/1/20 DeepSeek R1 | 71.5% |
見どころは、DeepSeekのV3からR1、OpenAIのGPT-4oからo1という推論重視への移行です。ただし、モデル間では計算量や評価手順が異なります。示されているpass@1は一回の回答の正解率に相当する指標であり、企業が導入した業務全体の成功率ではありません。
「R1の71.5%はo1の75.7%に近い」という比較は、この評価についての話です。文章の読みやすさ、日本語の応対、検索、料金、情報の管理まで同じという結論にはなりません。グラフは候補を理解する地図として使い、自分の作業に合うかは別に確かめます。
2025年|推論が広がり、コードと資料を扱う仕事へ
3月25日にGoogleが発表したGemini 2.5は、推論能力を前面に出しました。5月22日のClaude 4では、長く続くコード作業やツール利用を強調し、Claude Codeの一般提供も発表。8月7日のGPT-5では、速い応答と深い推論を一つのシステムで扱う方向が示されました。[Gemini 2.5]/[Claude 4]/[GPT-5]
実際の利用にも偏りが見えます。Anthropicが2025年2月に公表したEconomic Indexでは、Claude.aiの分析対象の会話で「コンピューター・数学」関連が37.2%を占めました。ソフトウェア開発や技術文書などが中心です。これはClaudeの利用データの分析で、全世界のAI利用や労働者全体の割合ではありません。[Anthropic Economic Index]
初心者に置き換えると、「プログラムの書き方を聞く」から「この不具合を直し、動くか確かめる」へ依頼が変わったということです。ただし、AIが操作するにはファイルや実行環境への接続が要ります。チャットで方法を説明できることと、実際に手元のソフトを動かせることは別です。
11月18日に登場したGemini 3も、アプリ、開発環境、検索など複数の入口へ展開されました。ここでGoogleが持つ強みは、モデル単体の順位に加え、普段の道具から使える接点です。反対に、同じGeminiの名前でも、利用画面・地域・プラン・モデルによって使える機能が違い、比較が分かりにくくなります。[Googleの発表]
2026年9月|高性能化と低価格化が同時に進む
OpenAIはGPT-6 Astraを、操作や成果物を伴う仕事に向けたモデルとして紹介しています。9月29日発表のGPT-6.1 Solでは、Astraに近い能力を標準の入出力トークン単価で5分の1にするという位置づけを示しました。これは開発元の説明で、すべての仕事が5分の1の総費用になる保証ではありません。[GPT-6 Astra]/[GPT-6.1 Sol]
AnthropicもOpus 5.5とSonnet 5.5を投入しました。Sonnet 5.5は、同社評価で前世代より速く、仕事によっては必要なトークンが減ると説明されています。単価が同じでも、一回の作業に必要な出力量ややり直しが減れば費用は下がる。今の価格競争は、料金表の一行だけでは判断できません。[Opus 5.5]/[Sonnet 5.5]
Googleの現行モデル案内にもGemini 3.8 Flashなど、効率と作業能力を両立させるモデルが掲載されています。「新しい最大モデルが出たか」だけを追うと、日常的に大量の処理を回すための改良を見落とします。最新モデル名は更新が速いため、本稿は上記基準日時点の記録です。[Google DeepMindの現行案内]
最新グラフ|「仕事の性能」も一つの点数では決まらない
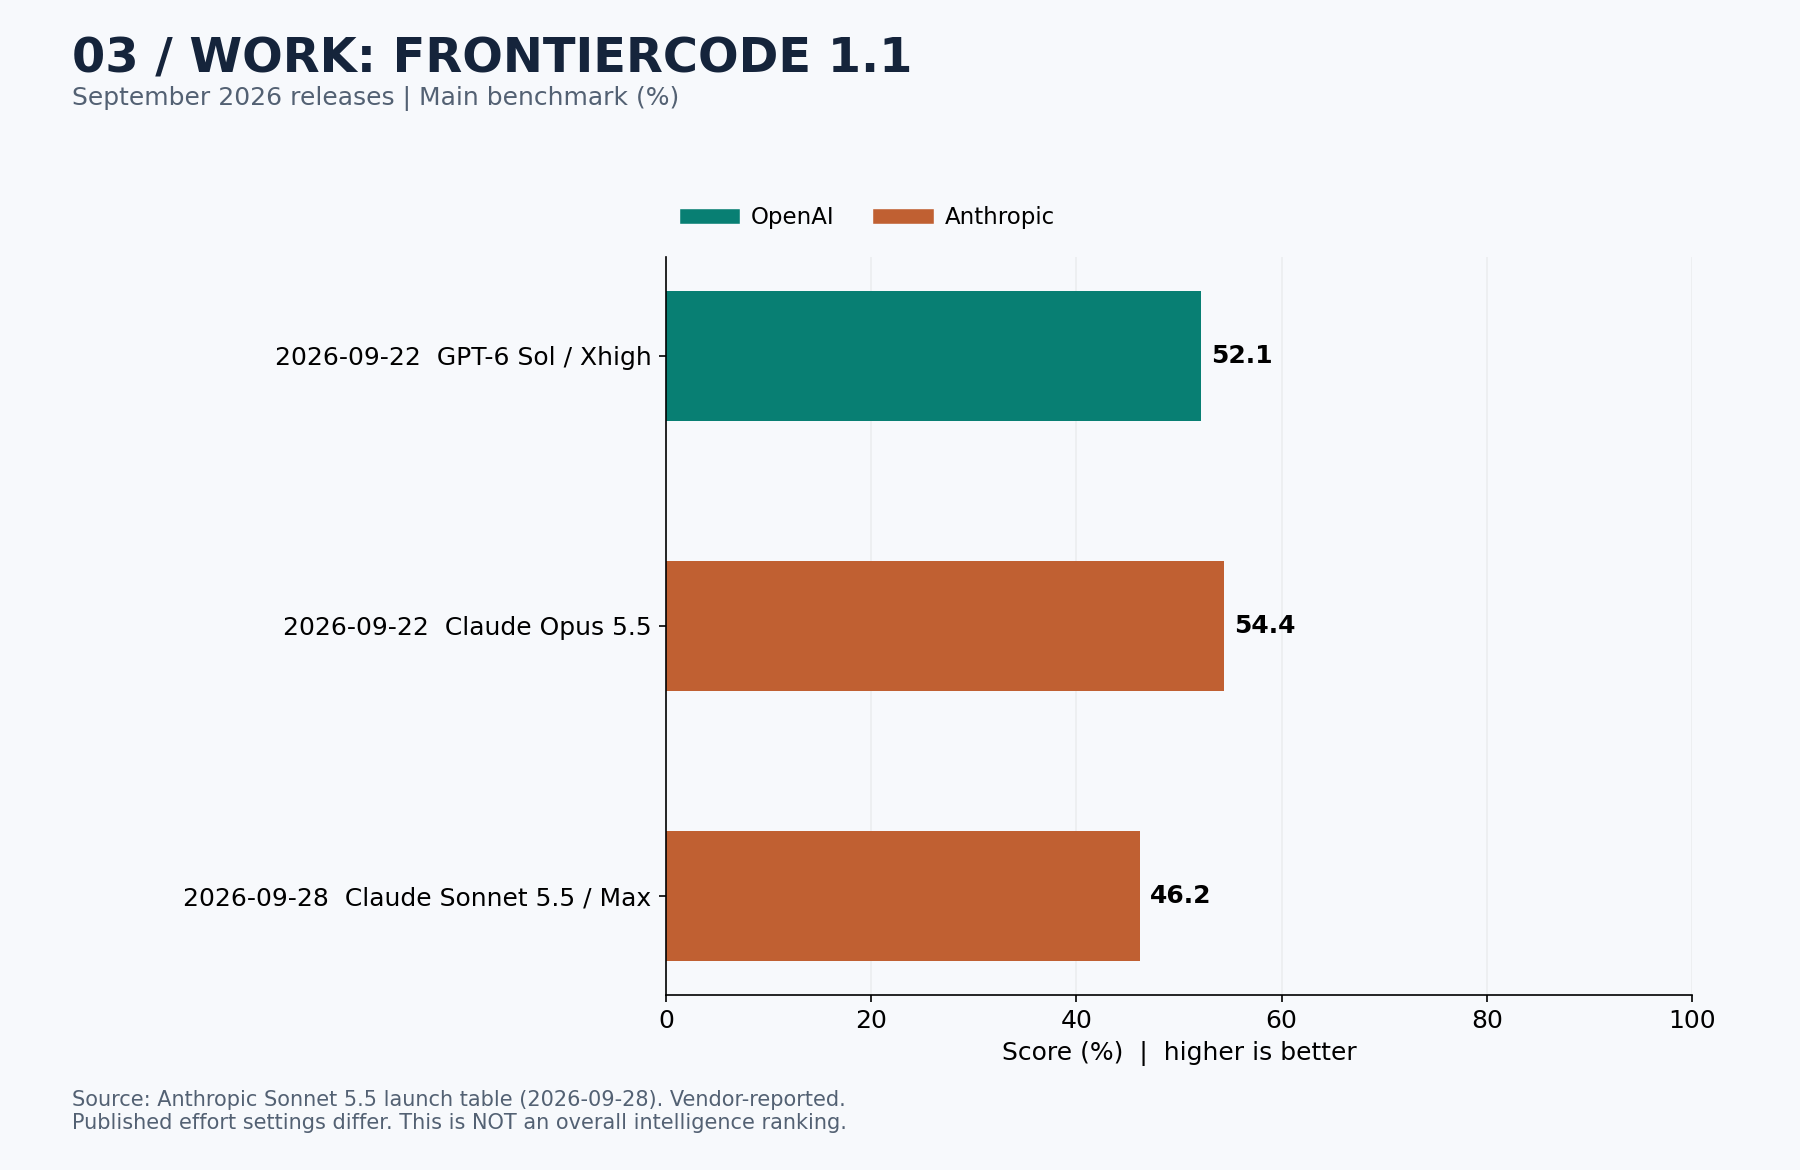
2026年9月の例として、AnthropicのSonnet 5.5公開資料にあるFrontierCode 1.1(Main)の値を並べます。コードの作業能力を見る評価で、前のGPQAやMMLUとは別軸です。推論設定は資料記載のままにしており、同じ費用・同じ処理時間で競わせたグラフではありません。
| 公開日/モデル | 公表値・条件 |
|---|---|
| 9/22 GPT-6 Sol | 52.1%(Xhigh) |
| 9/22 Claude Opus 5.5 | 54.4%(同表掲載値) |
| 9/28 Claude Sonnet 5.5 | 46.2%(Max) |
この図だけで「Sonnetには使う価値がない」と読むのも誤りです。複雑なコードの修正に強いモデルが、短い分類や文章整形にも最も経済的とは限りません。9月29日のGPT-6.1 Solも、同じ表の比較対象には入っていないため数値を補っていません。欠測をゼロにしたり、別の試験から推定したりしない方が誠実な比較になります。
初心者はどう使い分ければいい?
| やりたいこと | まず見る点 | 確かめる点 |
|---|---|---|
| 短いメール・要約 | 速さ、文章の読みやすさ | 原文にない事実を足していないか |
| 資料を読み比べる | 入力できる量、出典の扱い | 根拠のページや数字が合うか |
| 難問・コードの修正 | 推論と検証の能力 | テストで動くか、前提が正しいか |
| アプリを操作して作業 | 対応ツール、権限、履歴 | 保存先・変更範囲・外部送信の有無 |
| 自社環境で運用 | 公開方式、必要な計算資源 | ライセンス、保守、情報管理 |
まずは同じ小さな課題を、普段使うモデルと上位モデルに頼んで比べてみます。見るのは回答の長さではなく、確認と修正まで含めて何分かかったかです。簡単な作業で差がなければ軽いモデルを使い、難しい場面だけ上位へ切り替える、という選択ができます。
本稿の見立てでは、AI競争の中心は「何点取れるか」から「どこまで仕事を任せられ、どれだけ少ない手直しで済むか」へ広がっています。知識テストで優秀でも、操作の失敗、根拠の欠落、権限の取り違えがあれば実務では困る。性能と使い勝手、安全な運用を一緒に見ることが、最新ニュースに振り回されない読み方です。
グラフは代表モデルの抜粋で、全企業・全モデルの順位表ではありません。新旧の試験を接続しないため、2025〜2026年の全リリースを一本の線にしていません。画像生成AIは不使用。数値・日付・評価条件は本文のリンク先と照合できます。
コメント